Domain personal-trainer-ausbildung.de kaufen?
Wir ziehen mit dem Projekt
personal-trainer-ausbildung.de um.
Sind Sie am Kauf der Domain
personal-trainer-ausbildung.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain personal-trainer-ausbildung.de kaufen?
Wie funktioniert Speech to Text?
Speech to Text funktioniert, indem gesprochene Wörter mithilfe von Spracherkennungssoftware in Text umgewandelt werden. Dabei werden die Audiosignale des gesprochenen Textes analysiert und in Text umgewandelt. Die Software erkennt dabei Sprachmuster, Wörter und Sätze, um sie korrekt zu transkribieren. Dieser Prozess basiert auf komplexen Algorithmen und künstlicher Intelligenz, die kontinuierlich verbessert werden, um die Genauigkeit der Umwandlung zu erhöhen. Das Ergebnis ist ein geschriebener Text, der die gesprochene Sprache möglichst genau wiedergibt. **
Wie benutze ich Text to Speech?
Um Text-to-Speech zu verwenden, benötigen Sie zunächst eine Software oder eine App, die diese Funktion unterstützt. Öffnen Sie dann die gewünschte Textdatei oder geben Sie den Text ein, den Sie vorgelesen haben möchten. Wählen Sie die gewünschte Stimme und Sprache aus, und starten Sie die Wiedergabe. Sie können auch die Geschwindigkeit und Lautstärke der Sprachausgabe anpassen. Text-to-Speech ist eine nützliche Funktion für Menschen mit Sehbehinderungen oder für diejenigen, die sich Texte lieber vorlesen lassen möchten. **

Ähnliche Suchbegriffe für Springer-Neural-Text-to-Speech-Synthesis
Top-Angebote
Produkte zum Begriff Springer-Neural-Text-to-Speech-Synthesis:
-
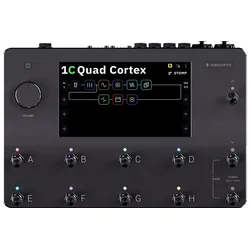
Neural DSP Quad CortexLeistungsstarker Floor Modeler mit 2 GHz dediziertem DSP, Neural Capture zur Analyse und Nachbildung des Klangs, 2 GHz Quad-Core SHARC Prozessorarchitektur, Integriertes Wifi für drahtlose Preset-Übertragung, 7-Zoll-Display mit Multi-Touch-Sensoren, Cab-Sim mit über 1000 Impulsantworten (IRs),1669,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
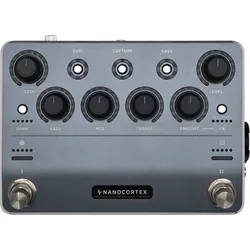
Neural DSP Nano CortexNeural-Capture-Technologie mit der gleichen Auflösung und Qualität wie bei Quad Cortex, Unglaublich genaue digitale Nachbildungen jedes Verstärkers, jeder Box oder jedes Drive-Pedals, Freier Zugriff auf Tausende von Neural Captures in der Cortex Cloud, Impulse Response Loader, Adaptive Noise Gate und Transpose-Funktion, Input Gate sowie 47 Effekte und Tools, Pre- und Post-FX Blöcke frei belegbar,569,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Graph Neural Network Training, Fachbücher von Lei Chen, Yanyan ShenDas Fachbuch "Graph Neural Network Training" bietet eine umfassende Analyse der effizienten Schulung von Graph Neural Networks (GNNs), die in der heutigen Datenlandschaft eine zentrale Rolle spielen. GNNs haben die Art und Weise revolutioniert, wie wir Informationen aus graphstrukturierten Daten lernen, und sind entscheidend für Anwendungen in sozialen Netzwerken, Empfehlungssystemen und der Biologie. Dieses Buch beleuchtet die Herausforderungen, die mit der hohen Rechenintensität des Nachrichtenaustauschs zwischen Knoten verbunden sind, und bietet innovative Ansätze zur Optimierung des Trainingsprozesses. Durch die Integration von Techniken aus der Graphverarbeitung wird aufgezeigt, wie die Effizienz in der GNN-Ausbildung gesteigert werden kann, ohne die Leistung zu beeinträchtigen. Die Leserinnen und Leser erhalten wertvolle Einblicke in den Lebenszyklus von Graphdaten und lernen, wie Datenmanagement-Techniken die Skalierbarkeit und Leistung von GNNs erheblich verbessern können. Das Buch richtet sich an ein breites Publikum, darunter Studierende, Forschende und Fachleute, und bietet klare Erklärungen sowie praktische Strategien zur Beherrschung des effizienten GNN-Trainings.142,76 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter

-
Wie kann man die JavaScript-Speech-Synthesis verbessern?
Um die JavaScript-Speech-Synthesis zu verbessern, könnten Sie zunächst sicherstellen, dass Sie die neueste Version des Browsers verwenden, da ältere Versionen möglicherweise nicht alle Funktionen unterstützen. Darüber hinaus könnten Sie verschiedene Sprachsynthese-APIs ausprobieren, um die beste Qualität und Genauigkeit der Sprachausgabe zu erzielen. Schließlich könnten Sie auch benutzerdefinierte Wörterbücher oder Ausspracheanweisungen verwenden, um spezifische Wörter oder Phrasen korrekt auszusprechen. **
-
Kennt jemand ein gutes Text-to-Speech-Programm?
Ja, es gibt verschiedene gute Text-to-Speech-Programme auf dem Markt. Einige beliebte Optionen sind Google Text-to-Speech, Amazon Polly und Microsoft Azure Text-to-Speech. Diese Programme bieten eine natürliche Sprachausgabe und können in verschiedenen Anwendungen wie Sprachassistenten, Vorleseprogrammen oder Barrierefreiheitstools verwendet werden. **
-
Was ist die beste KI für Text-to-Speech?
Es gibt viele gute KI-Modelle für Text-to-Speech, aber einige der bekanntesten und am weitesten entwickelten sind Tacotron 2, WaveNet und Deep Voice. Diese Modelle haben eine hohe Qualität und Natürlichkeit in der Generierung von Sprache und werden von vielen Unternehmen und Entwicklern verwendet. Es ist jedoch wichtig zu beachten, dass die "beste" KI für Text-to-Speech von den spezifischen Anforderungen und Präferenzen abhängt, da verschiedene Modelle unterschiedliche Stärken und Schwächen haben können. **
-
Wie funktioniert die Text-to-Speech-Funktion auf TikTok?
Die Text-to-Speech-Funktion auf TikTok verwendet eine Spracherkennungssoftware, um den eingegebenen Text in Sprache umzuwandeln. Die Software analysiert den Text und generiert dann eine Sprachausgabe, die im Video abgespielt wird. Die Benutzer können aus verschiedenen Sprachoptionen wählen und die Geschwindigkeit der Sprachausgabe anpassen. **


Gibt es ein Open-Source-Text-to-Speech-Modell?
Ja, es gibt mehrere Open-Source-Text-to-Speech-Modelle. Ein bekanntes Beispiel ist das Tacotron-Modell, das von Google entwickelt wurde. Es ermöglicht die Generierung von natürlicher Sprache aus Text und ist in der Open-Source-Community weit verbreitet. Es gibt auch andere Modelle wie WaveNet und DeepVoice, die ebenfalls Open-Source sind. **
Wie erstelle ich ein eigenes Text-to-Speech-Paket?
Um ein eigenes Text-to-Speech-Paket zu erstellen, benötigst du zunächst eine Sprachsynthese-Engine, die den Text in Sprache umwandelt. Du kannst eine vorhandene Engine verwenden oder eine eigene entwickeln. Anschließend musst du die Sprachdatenbank erstellen, die die Aufnahmen der Sprachausgabe enthält. Diese Datenbank kann aus Aufnahmen eines Sprechers bestehen oder durch die Kombination von vorhandenen Sprachdatenbanken erstellt werden. Schließlich musst du das Paket in einem geeigneten Format speichern, das von der gewünschten Plattform oder Anwendung unterstützt wird, z.B. als Plugin, Bibliothek oder Datei. **
Top-Angebote
Produkte zum Begriff Springer-Neural-Text-to-Speech-Synthesis:
-
BULL'S Niko Springer Fankarte Niko SpringerDie Niko Springer Fankarte ist ein absolutes Must-have für jeden Fan des legendären Meenzer Bub. Mit ihrem auffälligen Design und der perfekten Größe bringt sie die Bühnenpräsenz von Niko Springer direkt zu dir nach Hause oder in die Dartarena. Egal ob als Dekoration, für Autogramme oder als lautstarke Unterstützung bei Events - diese Fankarte überzeugt in jeder Situation. Hochwertiges Material für Langlebigkeit Gefertigt aus robustem Hartschaum, bietet die Niko Springer Fankarte eine außergewöhnliche Stabilität. So bleibt sie auch bei intensiver Nutzung in einem einwandfreien Zustand und ist der ideale Begleiter für alle Deine sportlichen Events. Perfekte Maße für jeden Einsatz Mit ihren Maßen von 34,5 x 24,5 cm liegt die Fankarte optimal in der Hand und ist leicht zu transportieren. Sie ist nicht nur ein echter Hingucker, sondern auch äußerst praktisch für den Einsatz bei Darts-Events oder als dekoratives Element in Deinem Zuhause. Ein Zeichen der Unterstützung Zeige Deine Begeisterung und Unterstützung für Niko Springer mit dieser einzigartigen Fankarte. Sie ist das perfekte Accessoire für alle, die ihre Leidenschaft für den Sport und den Spieler zum Ausdruck bringen möchten. Produktdetails Material: Hartschaum für Stabilität und Langlebigkeit Sichere dir jetzt die Niko Springer Fankarte und feiere deinen Lieblingsspieler auf eine ganz besondere Weise!22,95 €*Versand: 5,99 €Sichere Weiterleitung zum Anbieter
-
Neural DSP Quad CortexLeistungsstarker Floor Modeler mit 2 GHz dediziertem DSP, Neural Capture zur Analyse und Nachbildung des Klangs, 2 GHz Quad-Core SHARC Prozessorarchitektur, Integriertes Wifi für drahtlose Preset-Übertragung, 7-Zoll-Display mit Multi-Touch-Sensoren, Cab-Sim mit über 1000 Impulsantworten (IRs),1669,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Neural DSP Nano CortexNeural-Capture-Technologie mit der gleichen Auflösung und Qualität wie bei Quad Cortex, Unglaublich genaue digitale Nachbildungen jedes Verstärkers, jeder Box oder jedes Drive-Pedals, Freier Zugriff auf Tausende von Neural Captures in der Cortex Cloud, Impulse Response Loader, Adaptive Noise Gate und Transpose-Funktion, Input Gate sowie 47 Effekte und Tools, Pre- und Post-FX Blöcke frei belegbar,569,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Wie funktioniert Speech to Text?
Speech to Text funktioniert, indem gesprochene Wörter mithilfe von Spracherkennungssoftware in Text umgewandelt werden. Dabei werden die Audiosignale des gesprochenen Textes analysiert und in Text umgewandelt. Die Software erkennt dabei Sprachmuster, Wörter und Sätze, um sie korrekt zu transkribieren. Dieser Prozess basiert auf komplexen Algorithmen und künstlicher Intelligenz, die kontinuierlich verbessert werden, um die Genauigkeit der Umwandlung zu erhöhen. Das Ergebnis ist ein geschriebener Text, der die gesprochene Sprache möglichst genau wiedergibt. **
-
Wie benutze ich Text to Speech?
Um Text-to-Speech zu verwenden, benötigen Sie zunächst eine Software oder eine App, die diese Funktion unterstützt. Öffnen Sie dann die gewünschte Textdatei oder geben Sie den Text ein, den Sie vorgelesen haben möchten. Wählen Sie die gewünschte Stimme und Sprache aus, und starten Sie die Wiedergabe. Sie können auch die Geschwindigkeit und Lautstärke der Sprachausgabe anpassen. Text-to-Speech ist eine nützliche Funktion für Menschen mit Sehbehinderungen oder für diejenigen, die sich Texte lieber vorlesen lassen möchten. **
-
Wie kann man die JavaScript-Speech-Synthesis verbessern?
Um die JavaScript-Speech-Synthesis zu verbessern, könnten Sie zunächst sicherstellen, dass Sie die neueste Version des Browsers verwenden, da ältere Versionen möglicherweise nicht alle Funktionen unterstützen. Darüber hinaus könnten Sie verschiedene Sprachsynthese-APIs ausprobieren, um die beste Qualität und Genauigkeit der Sprachausgabe zu erzielen. Schließlich könnten Sie auch benutzerdefinierte Wörterbücher oder Ausspracheanweisungen verwenden, um spezifische Wörter oder Phrasen korrekt auszusprechen. **
-
Kennt jemand ein gutes Text-to-Speech-Programm?
Ja, es gibt verschiedene gute Text-to-Speech-Programme auf dem Markt. Einige beliebte Optionen sind Google Text-to-Speech, Amazon Polly und Microsoft Azure Text-to-Speech. Diese Programme bieten eine natürliche Sprachausgabe und können in verschiedenen Anwendungen wie Sprachassistenten, Vorleseprogrammen oder Barrierefreiheitstools verwendet werden. **
Ähnliche Suchbegriffe für Springer-Neural-Text-to-Speech-Synthesis
-
Graph Neural Network Training, Fachbücher von Lei Chen, Yanyan ShenDas Fachbuch "Graph Neural Network Training" bietet eine umfassende Analyse der effizienten Schulung von Graph Neural Networks (GNNs), die in der heutigen Datenlandschaft eine zentrale Rolle spielen. GNNs haben die Art und Weise revolutioniert, wie wir Informationen aus graphstrukturierten Daten lernen, und sind entscheidend für Anwendungen in sozialen Netzwerken, Empfehlungssystemen und der Biologie. Dieses Buch beleuchtet die Herausforderungen, die mit der hohen Rechenintensität des Nachrichtenaustauschs zwischen Knoten verbunden sind, und bietet innovative Ansätze zur Optimierung des Trainingsprozesses. Durch die Integration von Techniken aus der Graphverarbeitung wird aufgezeigt, wie die Effizienz in der GNN-Ausbildung gesteigert werden kann, ohne die Leistung zu beeinträchtigen. Die Leserinnen und Leser erhalten wertvolle Einblicke in den Lebenszyklus von Graphdaten und lernen, wie Datenmanagement-Techniken die Skalierbarkeit und Leistung von GNNs erheblich verbessern können. Das Buch richtet sich an ein breites Publikum, darunter Studierende, Forschende und Fachleute, und bietet klare Erklärungen sowie praktische Strategien zur Beherrschung des effizienten GNN-Trainings.142,76 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Introduction to English Text-linguistics, Fachbücher von Jürgen EsserDas Buch "Introduction to English Text-linguistics" bietet eine umfassende Einführung in die englische Textlinguistik. Es behandelt zentrale Themen wie Kohäsion und Kohärenz, die in der englischen Linguistik weitreichende Beachtung gefunden haben. Darüber hinaus werden korpusbasierte Studien zu lexikalischen Mustern und Textklassifikationen sowie psycholinguistische und kognitive Ansätze zur Textkonstitution und Decoder-Orientierung behandelt. Ein besonderes Merkmal dieses Werkes ist die Berücksichtigung sowohl abstrakter lexikalischer und grammatikalischer Strukturen als auch der medienabhängigen schriftlichen und mündlichen Präsentation. Diese Kombination macht das Buch zu einer wertvollen Ressource für Studierende und Fachleute, die sich mit der Analyse und dem Verständnis von Texten in der englischen Sprache beschäftigen.26,10 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Smart Speech, Fachbücher von Peter FlumeEinen überzeugenden Vortrag zu erstellen, ist oft mit einem hohen Zeitaufwand verbunden. Durch den gezielten Einsatz von Künstlicher Intelligenz lässt sich die Vorbereitungszeit jedoch um bis zu 75 % reduzieren und die Qualität der Präsentationen gleichzeitig spürbar verbessern. In diesem Buch von Peter Flume wird erklärt, wie KI-Agenten mit rhetorischen Grundlagen so trainiert werden können, dass sie individuelle und überzeugende Redemanuskripte erstellen, in denen die eigene Rednerpersönlichkeit erhalten bleibt. Darüber hinaus werden die Grenzen der KI beleuchtet und aufgezeigt, wie diese produktiv genutzt werden können und wie KI auch bei fremdsprachigen Präsentationen eine wertvolle Hilfe ist. Die vorgestellten Methoden sind direkt anwendbar und praxisnah. Inhalte: - KI nutzen für mehr Überzeugungskraft: schnelle Strukturierung, sprachliche Optimierung, inhaltliche Tiefe - Effiziente Workflows mit KI-Tools entwickeln und einsetzen - Inhalte mithilfe von KI zielgruppenorientiert aufbereiten - Anpassung generierter Texte an den eigenen Redestil - Gezielte Vorbereitung auf Rückfragen und Einwände - Wirkung vor Publikum steigern durch Sprache und Körpersprache - Souveräner Umgang mit Rückfragen und kritischen Situationen - Aufmerksamkeit sichern durch spannende Titel und Dramaturgie - Unterschiedliche Erzählhaltungen für verschiedene Publikumstypen einsetzen - Schlagfertigkeit und Deeskalation trainieren.29,99 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Was ist die beste KI für Text-to-Speech?
Es gibt viele gute KI-Modelle für Text-to-Speech, aber einige der bekanntesten und am weitesten entwickelten sind Tacotron 2, WaveNet und Deep Voice. Diese Modelle haben eine hohe Qualität und Natürlichkeit in der Generierung von Sprache und werden von vielen Unternehmen und Entwicklern verwendet. Es ist jedoch wichtig zu beachten, dass die "beste" KI für Text-to-Speech von den spezifischen Anforderungen und Präferenzen abhängt, da verschiedene Modelle unterschiedliche Stärken und Schwächen haben können. **
-
Wie funktioniert die Text-to-Speech-Funktion auf TikTok?
Die Text-to-Speech-Funktion auf TikTok verwendet eine Spracherkennungssoftware, um den eingegebenen Text in Sprache umzuwandeln. Die Software analysiert den Text und generiert dann eine Sprachausgabe, die im Video abgespielt wird. Die Benutzer können aus verschiedenen Sprachoptionen wählen und die Geschwindigkeit der Sprachausgabe anpassen. **
-
Gibt es ein Open-Source-Text-to-Speech-Modell?
Ja, es gibt mehrere Open-Source-Text-to-Speech-Modelle. Ein bekanntes Beispiel ist das Tacotron-Modell, das von Google entwickelt wurde. Es ermöglicht die Generierung von natürlicher Sprache aus Text und ist in der Open-Source-Community weit verbreitet. Es gibt auch andere Modelle wie WaveNet und DeepVoice, die ebenfalls Open-Source sind. **
-
Wie erstelle ich ein eigenes Text-to-Speech-Paket?
Um ein eigenes Text-to-Speech-Paket zu erstellen, benötigst du zunächst eine Sprachsynthese-Engine, die den Text in Sprache umwandelt. Du kannst eine vorhandene Engine verwenden oder eine eigene entwickeln. Anschließend musst du die Sprachdatenbank erstellen, die die Aufnahmen der Sprachausgabe enthält. Diese Datenbank kann aus Aufnahmen eines Sprechers bestehen oder durch die Kombination von vorhandenen Sprachdatenbanken erstellt werden. Schließlich musst du das Paket in einem geeigneten Format speichern, das von der gewünschten Plattform oder Anwendung unterstützt wird, z.B. als Plugin, Bibliothek oder Datei. **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.